From Recursive Generalization to Generation Order: Some Thoughts on Neural Network Learning and Generation
A note on 'neural networks are already clean'.
Representation Learning / Generative Models / Mechanistic Interpretability
最近读了 Goodfire 的 Neural Networks Are Already Clean,觉得这是一篇很有意思的文章。
这篇文章主要讨论的是 Mechanistic Interpretability,其中我觉得最有意思的部分是作者对 the nature of neural networks,尤其是神经网络如何学习和组织内部表示的讨论。
1 Recursive Generalization:神经网络究竟在学习什么?
在 Mechanistic Interpretability 中,一个长期存在的问题是 Polysemanticity:为什么同一个神经元会对多个看似不相关的概念产生响应?过去一个重要的解释是 Superposition。由于网络的表示容量有限,它可能不得不将不同的特征编码到共享的表示空间中,即使这些特征之间没有明显的语义联系。但 Goodfire 提出了另一种解释:Recursive Generalization。
作者发现,许多看似不相关的神经元响应,实际上可以追溯到一系列局部的、合理的泛化过程。例如,一个神经元最初响应 "iy",随后扩展到 "diy",最终又能够响应 "do it yourself",尽管后者已经不包含最初的字符模式。这种现象更像是树枝不断长出新的分支:一个已经存在的特征沿着相关方向扩展,而新的分支又可以继续泛化。作者将其概括为:Generalization is fractal.
这意味着,神经网络内部看似复杂、混乱的表示,可能并不是许多不相关概念的任意组合,而是通过递归泛化形成的一种有组织的结构。文章中还有一个很有意思的观察:当模型容量较小时,神经元往往表示更宽泛的概念;当容量增加时,这些概念可能进一步分化为更具体的特征。
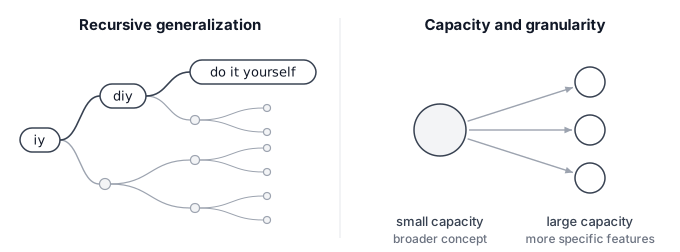
"iy",随后扩展到 "diy",最终能够响应 "do it yourself";每个已有的特征都可能沿相关方向继续分叉(灰色分支示意其他可能的泛化方向)。右:模型容量较小时,神经元往往表示更宽泛的概念;容量增加时,这些概念可能分化为更具体的特征。这让我觉得,Coarse-to-Fine 也许不仅是一种人为设计的层次结构,还可能与神经网络自然形成表示的方式有关。
2 Circuit Ecology:为什么会产生 Recursive Generalization?
除了Recursive Generalization,另外一个让我很感兴趣的是作者对其形成机制的解释:Circuit Ecology。
作者猜测,神经网络内部不同的 neurons 和 circuits 实际上存在一种竞争关系。当模型需要学习一个新模式时,如果某个已有的 circuit 已经能够部分处理相关信息,那么它就可能比一个从零开始构建的新 circuit 更快地捕获训练误差信号。换句话说,已有的计算结构具有一种优化上的先发优势。 新的功能不一定需要独立的神经元,而可能直接从已有的计算结构中扩展出来。随着训练继续,这种扩展又成为进一步学习的基础。
因此,Recursive Generalization 可能不是某种特殊的编码技巧,而是普通的梯度优化与特征复用共同产生的结果。我觉得这其实可以看作一种关于 Learning Dynamics 的理论假说,虽然目前还不是一个经过严格证明的 Learning Theory。
它让我开始思考:为什么神经网络能够从随机初始化出发,自发形成可复用、有组织、具有不同抽象粒度的表示?为什么优化过程会倾向于复用相关特征,而不是为每个新概念建立完全独立的表示?作者并没有完全回答这些问题,但 Circuit Ecology 提供了一个很有意思的方向:或许表示结构不仅取决于数据本身,还取决于不同计算结构在优化过程中的竞争与复用。
3 这和 Coarse-to-Fine Generation 有什么关系?
最近我一直在思考 Coarse-to-Fine Diffusion,以及它对生成过程本身意味着什么。Goodfire 的文章让我重新考虑一个问题:Coarse-to-Fine 会不会不仅是一种有效的生成策略,还反映了某种更一般的学习规律?
当然,Recursive Generalization 描述的是学习过程中神经元如何发展,而 Coarse-to-Fine Generation 描述的是生成时信息如何被逐步确定。它们并不是一回事。但两者确实存在一种值得研究的结构性联系:先建立可以复用的共享结构,再在这个结构的基础上处理更加具体的信息。 例如,在视频生成中,不同帧之间具有大量共享依赖:场景布局、物体身份、运动状态,以及长期的时序关系。假设存在一个 coarse representation,能够捕获这些全局共享信息。那么在给定这个 representation 后,不同帧、不同空间区域之间的剩余依赖可能显著减弱。这意味着,我们可以先生成全局状态,再在其条件下生成局部细节。相比之下,如果所有变量从一开始就联合生成,模型可能需要在整个采样过程中不断协调这些全局依赖。这也许可以解释为什么 Coarse-to-Fine Generation 对视频、长文本等需要长期 consistency 的任务尤其有吸引力。
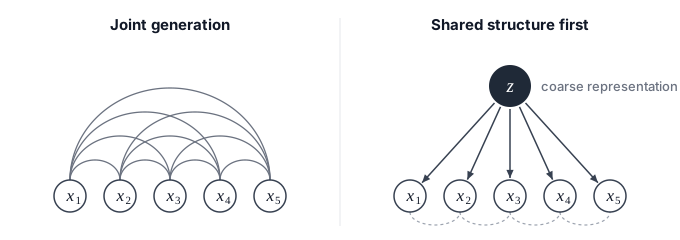
但这里真正重要的,我认为不是空间尺度意义上的 Coarse-to-Fine,而是:Can we resolve shared dependencies first, so that the remaining generation becomes easier? 如果某种 coarse representation 可以解释大量变量之间的依赖,那么先确定它,也许能够显著简化后续的条件生成。不过,这是否真的能够改善生成模型的 learnability,仍然需要独立验证。
4 Coarse-to-Fine 本质上是一个更广义的 Generation Order 问题
进一步想,我觉得 Coarse-to-Fine 可能只是 Generation Order 的一种特殊形式。Generation Order 一直是 Discrete Diffusion Language Models 中的重要研究问题。例如,Masked Diffusion 可以通过不同的 unmasking schedules,决定哪些 tokens 先生成,哪些 tokens 后生成。但这类方法通常仍然受到固定 token representation 的限制。它们主要是在给定 token 集合之后,选择一个更好的生成顺序。
我现在更感兴趣的是一个更加 general 的问题:In what order should a generative model resolve different kinds of uncertainty? 这里的生成对象不一定是 tokens,也可以是:
- 全局语义或抽象概念
- 局部内容和细节
- 空间频率或不同尺度的结构
- 跨时间共享的动态状态
- Learned latent variables 或某些连续的表示方向
甚至这个 order 也不一定是一个固定的离散排列。对于 Continuous Diffusion,不同的信息可以同时演化,但它们的不确定性可能以不同的速度被解决。因此,Generation Order 也可以是一种连续的、动态的 Information Resolution Process。从这个角度来看,Autoregressive、Discrete Diffusion、Continuous Diffusion、Coarse-to-Fine 和 Hierarchical Generation,都可以被看作组织信息生成的不同方式。
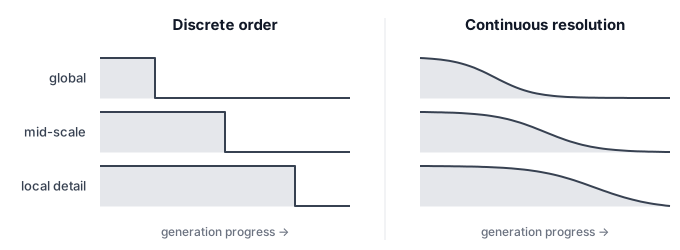
那么,一个自然的问题就是:什么样的 Generation Order 才是好的? 我目前比较倾向于下面这个设想:
The learnability of a generative model depends not only on its architecture and objective, but also on the order in which different dependencies are resolved.
也就是说,生成模型的学习难度不仅取决于网络架构和训练目标,还可能取决于它按照什么顺序处理数据中的不同依赖关系。这里的关键并不是简单地优先生成条件熵最低、或者最容易预测的变量。有些变量本身可能很难生成,但一旦被确定,就能大幅降低大量其他变量的条件复杂度。这种变量也许反而值得优先生成。这也让我想到 The Flexibility Trap 中一个很有意思的发现:一些高熵的逻辑连接词实际上是决定 reasoning trajectory 的关键分叉点,但 Discrete DLM 可能因为这些 tokens 难以预测而选择绕过它们,优先生成其他低熵的 tokens,反而过早限制了后续的推理路径。这似乎也说明,Generation Order 不应该只取决于变量本身有多容易生成,还应该考虑它对后续生成过程的影响。
因此,最好的 Generation Order 不一定是 Coarse-to-Fine,也不一定是某种固定的 token order,而应该由数据的 Dependency Structure 以及模型的学习能力共同决定。
5 Can We Derive an Optimal Generation Process?
我觉得根据以上的理解,目前的一个研究问题就是: Given a data distribution and its dependency structure, can we derive a generation process that achieves the best learnability and efficiency?
换句话说,如果我们知道数据中的变量如何相互依赖,是否能够系统地决定:哪些变量应该先生成?哪些依赖应该优先解决?哪些变量适合联合生成?哪些变量应该在某些共享状态确定之后再生成?更进一步,我们能否从理论上解释,为什么一种生成顺序会比另一种更容易学习?
这里的 Learnability 需要一个严格的定义。它可以涉及有限数据、模型容量和训练计算量下的生成误差,也可以涉及学习复杂度、条件分布的复杂程度,以及有限采样预算下的最终生成质量。可能我后面再仔细思考一下。
值得注意的是,从概率分解的角度,不同生成顺序并不一定改变数据分布本身所包含的信息量。因此,一种生成顺序的优势,可能并不是减少了需要生成的总信息,而是将一个复杂的联合生成问题重新组织成了一组更容易被有限模型学习、近似和采样的子问题。 当然,也可能有一些数据分布天然更适合 Joint Generation,而不是显式的 Coarse-to-Fine。所以 Coarse-to-Fine 也不一定就是一种很好的生成方式。
我比较感兴趣的是:能不能从数据的依赖结构出发,找到决定生成过程可学习性的更一般规律? Goodfire 的 Recursive Generalization 提供了一个很有启发的视角:神经网络内部的表示可能并不是任意组织的,而是在学习过程中自然形成了一套可复用的结构。如果这种结构与生成过程的 learnability 存在某种更深层的联系,那么我们或许可以进一步理解:什么应该先生成,以及为什么。
如果你有任何想讨论的想法,欢迎联系我:xsfeng@gatech.edu